
创新点:
①通过finetune让ResNet-50达到Transformer的准确率
以下文章已经描述得很清晰,就不再赘述了:
https://zhuanlan.zhihu.com/p/455913104
简述涨点方法:
①训练epoch从90扩大到300
②借鉴Swin-T的训练策略
③反瓶颈层加大卷积核7-1-1
④采用depthwise卷积
④ReLU替换为GELU
总体三个模型的结构

但是好像并不在各种任务通用:

创新点:
①通过finetune让ResNet-50达到Transformer的准确率
以下文章已经描述得很清晰,就不再赘述了:
https://zhuanlan.zhihu.com/p/455913104
简述涨点方法:
①训练epoch从90扩大到300
②借鉴Swin-T的训练策略
③反瓶颈层加大卷积核7-1-1
④采用depthwise卷积
④ReLU替换为GELU
总体三个模型的结构
但是好像并不在各种任务通用:
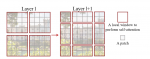
创新点: ①把transformer引入计算机视觉 ②把transformer中多头自注意力(MSA)模块替换成基于滑动窗口的模块 滑动窗口机制 红框窗口表示一个自注意力块,灰块在其中计算自注意力...
创新点: ①空间注意力机制 ②加入鉴别器,可以让网络生成多尺度图像(SPARNetHD) 总体结构 主要由三个模块构成: 降尺度模块 特征提取模块 升尺度模块 低分图像首先经过双线性插...

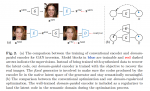
一个对于图像生成GAN逆转域的研究(GAN反演) 以前方法存在的问题:只能把图像逆转为像素,而不是原始的潜在空间(latent space) 创新点: ①可以在语义空间上对latent code编辑再...
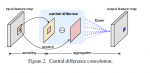
首先描述一下普通卷积的公式: p0代表当前输入输出的位置,pn代表R的所有枚举。 w(pn)代表pn位置的卷积核权重 ,x(p0+pn)代表p0偏移了pn位置后取得值,权重和值乘积累加后得到y(p...
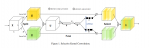
sknet是一个卷积结构,可以扩大卷积的感受野,并且能让卷积同时捕获到3*3和5*5的特征。 整体结构 CODE sknet的主体分为4个stage,每个stage由多个SKUnit构成 class SKNet(nn.Modu...
创新点: ①对LR图像处理成分层次的子块,通过迭代的网络,形成从小到大不同size的区域。 ②基于通道注意力的位置编码策略。 ③基于卷积的多层注意力组 总体结构 分层patch的Transfor...
创新点: ①通过距离来算自注意力,距离近的patch比较精细,距离远的比较粗糙,从而减少大分辨率图像的计算量 总体结构 总体结构与传统的Vit相差不大,每个patch大小为4×4,每个s...
