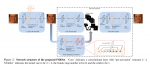
创新点:
①通过finetune让ResNet-50达到Transformer的准确率
以下文章已经描述得很清晰,就不再赘述了:
https://zhuanlan.zhihu.com/p/455913104
简述涨点方法:
①训练epoch从90扩大到300
②借鉴Swin-T的训练策略
③反瓶颈层加大卷积核7-1-1
④采用depthwise卷积
④ReLU替换为GELU
总体三个模型的结构

但是好像并不在各种任务通用:

创新点:
①通过finetune让ResNet-50达到Transformer的准确率
以下文章已经描述得很清晰,就不再赘述了:
https://zhuanlan.zhihu.com/p/455913104
简述涨点方法:
①训练epoch从90扩大到300
②借鉴Swin-T的训练策略
③反瓶颈层加大卷积核7-1-1
④采用depthwise卷积
④ReLU替换为GELU
总体三个模型的结构
但是好像并不在各种任务通用:
创新点: ①交互式的控制图片的变化 给定一对(handle point, target point),本方法以一种优化的方式执行图像操作。如上图所示,每个优化步骤由两个子步骤组成,包括 1)运动监督...

(CVPR2022论文) 以前存在的问题:静态和动态卷积要么与布局无关,要么计算量大,不适用于特定于布局的应用程序,例如人脸识别和医学图像分割。 创新点: ①作者观察到人脸识别的...
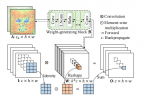
创新点: ①解决高分辨率图像的图像恢复任务中transformer复杂度高的问题 ②在图像运动去模糊,去焦去模糊,图像去噪(高斯灰度/颜色去噪,和真实图像去噪)任务中取得sota ③self-at...
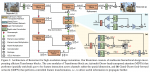
StyleGAN StyleGAN是由Nvidia研究人员于2018年12月推出的生成对抗网络,并于2019年2月可用。 StyleGAN依赖于Nvidia的CUDA软件,GPU和Google的TensorFlow。 StyleGAN的第二个版本(...
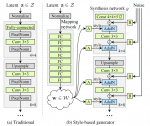
(CVPR2022的去噪论文) 创新点: ①本文提出Swin-Conv模块,将DRUNet和SwinIR的结合起来,并插入到UNet架构中,还设计了一个实用的噪声退化模型,最终在盲图像去噪上表现SOTA。 ②...
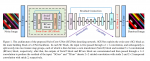
创新点: ①空间注意力机制 ②加入鉴别器,可以让网络生成多尺度图像(SPARNetHD) 总体结构 主要由三个模块构成: 降尺度模块 特征提取模块 升尺度模块 低分图像首先经过双线性插...

创新点: ①利用几何先验,即面部地标热图和解析图 ②引入对抗性网络(FSRGAN) 总体流程:先经过一个网络来恢复粗糙图像,然后进入两个分支分别是精细的SR编码器和先验信息评估网络。...